
2026年9月14至18日,欧洲中期天气预报中心(ECMWF)年度研讨会以资料同化为主题,五天里多个团队报告了把机器学习放进同化循环的结果。模拟出来的集合成员方差逐循环变大,用一年数据学到的模式误差修正换到下一年几乎失效;同一周里,5个成员加一个卷积网络顶替了50个成员的方差估计,一个只有58个参数的海冰网络改进了中纬度中期预报。
上一篇文章写的是这次研讨会上最激进的路线:ECMWF的AIFS-DOP完全不用数值预报分析场,直接从观测预测观测。本文写另一条更接近业务的路线,即保留4D-Var和集合同化的框架,用机器学习替换其中最贵或最难建模的部件。下文从这条路线的动机、ECMWF的三项工作、NOAA的部件替换、理想试验给出的规律,以及成败背后的共同条件等方面展开分析。
同化系统里哪些部件最贵
ECMWF的集合资料同化(EDA)是50个并行的扰动4D-Var,每个成员都要做一次完整的变分极小化,成本随成员数线性增长,大头花在模式的切线性和伴随模式(TL/AD)上。切线性模式描述预报模式对初始小扰动的线性响应,伴随模式把它反过来算,4D-Var靠这一对模式求代价函数的梯度。EDA的产出有两个用途:给集合预报提供初值,以及提供随流型变化的背景误差估计,也就是4D-Var里B矩阵的来源。B矩阵描述背景场(短期预报)各处的误差有多大、不同位置和变量之间的误差如何相关,决定了分析时观测和背景场各占多少权重。
算力约束在这次会上被反复提起。ECMWF原计划的内循环分辨率升级因算力不够被搁置,有与会者形容高性能计算市场“不仅更贵,而且完全未知”。闭幕时Stephen English提出“Moore’s Affordable Compute Law”,要看能负担多少算力,而不只是有多少算力。另一方面,ECMWF下一代同化框架Ext-Win DA和长期规划中的重叠滑动窗口,都要求更频繁地运行EDA。
NOAA的动机类似。负责报告的Daryl Kleist(NOAA/NWS建模与发展办公室副主任)说,两年前他们要求同化团队部分成员拿出至少20%至25%的时间做小规模机器学习项目,目标是给经典同化系统贡献部件,现在正逐渐转向整体替换。
5个成员加一个CNN,顶替50个成员的方差
ECMWF的Wei Pan和Ivo Pasmans把B矩阵拆成平衡关系、相关结构和方差三部分,只用机器学习处理方差。理由是方差决定观测与背景场的相对权重,估错了影响大,而它的结构相对简单。
做法是输入5个成员算出的样本方差,输出50个成员样本方差的概率分布。网络是U-Net结构的卷积网络,在N80网格、137层上处理涡度、散度、温度、地面气压对数、比湿、臭氧6个变量,用2023年全年数据训练,每个模型不到20万个参数。
3个月的循环试验给出了三组对比:
| 方差来源 | 观测拟合(O−B统计) | 12至72小时预报 |
|---|---|---|
| 50个成员(业务对照) | 基准 | 基准 |
| 只用5个成员 | 明显变差 | 显著退化 |
| 5个成员加ML | 与对照基本持平,IASI部分通道拟合更紧 | 接近中性 |
讲者同时给出了理论边界:以均方误差衡量,只用5个样本构造的任何估计都不可能完美复制50成员估计;但在适定情形下,4D-Var分析增量随B连续变化,B的小误差只带来增量的小误差。方差这一路已经整理成论文投稿QJRMS。
模拟成员接进循环后,方差一路变大
更进一步的尝试是直接模拟EDA成员。思路是保留少量真正做4D-Var的成员负责同化观测,机器学习模仿这些成员从预报到分析的转换,作用到其余成员的背景场上。网络本身不直接同化观测,观测信息经由“引导成员”间接引入。
网络基于ECMWF的开源AI框架Anemoi,用图神经网络加流匹配(flow matching)训练,数据是2024年11月至2025年12月的业务50成员EDA,T255分辨率,共686个变量,在单节点4块GH200上训练。受显存限制,配置为12个4D-Var引导成员加38个模拟成员。离线诊断表现不错:不在训练集里的2026年4月12日个例中,地面气压扰动谱与真值吻合;台风海鸥(Kalmaegi)个例中,模拟集合复现了受观测约束的地面气压离散度结构,这个结构与背景场离散度差别很大。
问题出在接入循环之后。Ivo Pasmans在研究版集合同化系统里用10个成员做试验,其中5个改为模拟成员。单次分析增量的量级和形态与参照试验相似,短期预报差异大多落在95%置信区间内。但F检验显示,非模拟成员的方差与参照一致,模拟成员的方差随时间持续增大,高层尤其明显。
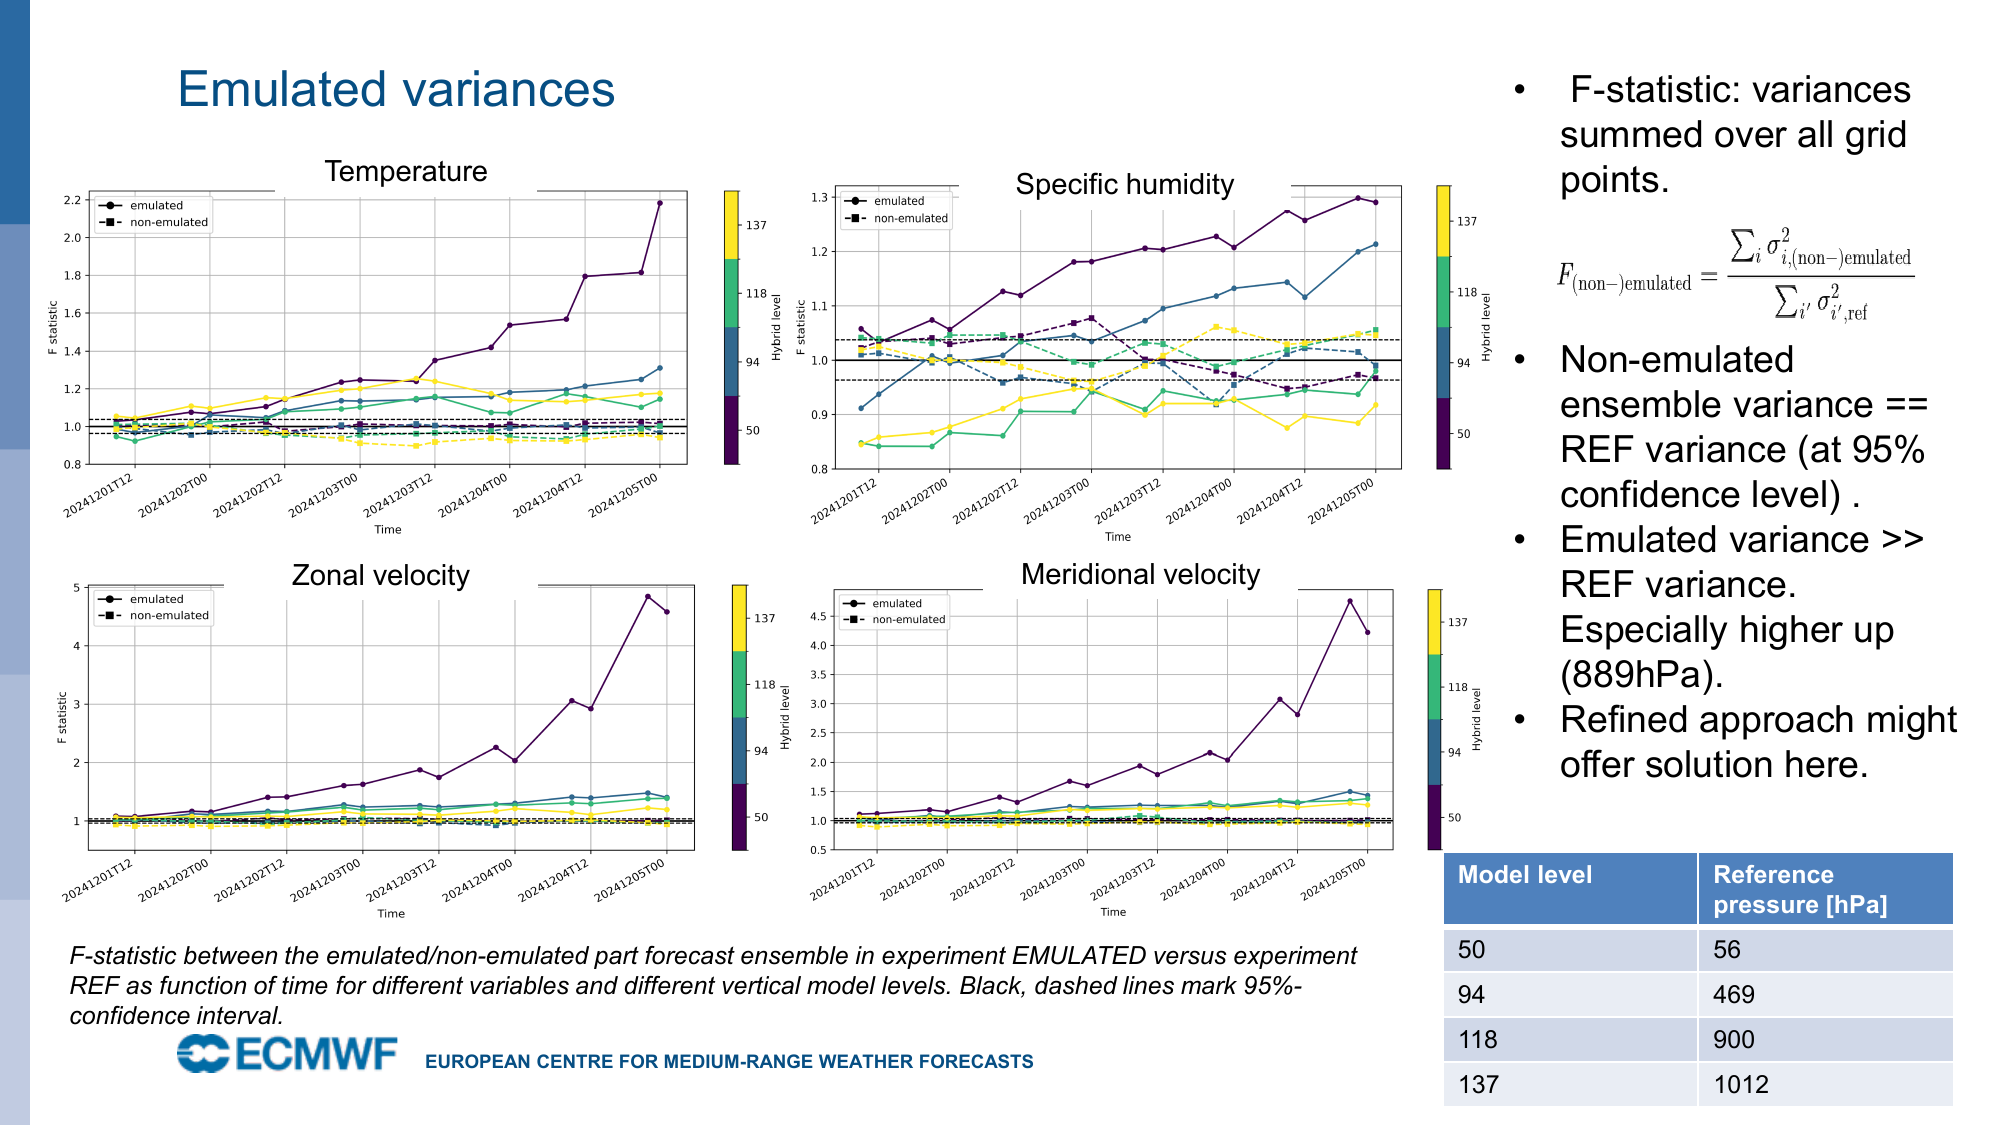
团队列了三个可能原因:模式与模拟器之间的网格插值;损失函数对方差本就较小的高层权重不够;从50成员训练迁移到只有5个引导成员的系统,比预期困难。Pasmans强调的是机制层面的缺失:经典集合4D-Var里有一条负反馈,离散度变大让B变大,B变大让分析更信任观测,离散度随之被压回去,这条负反馈在模拟成员身上“严重缺失”。训练只保证单个循环的保真度,在循环同化中做多步滚动训练,计算上不可行。
下一步是通过微调损失函数,以及在推理时把模拟成员的方差向非模拟成员“拉”(nudging),把循环稳定性作为首要要求。
训练一年、换一年就失效:IFS的模式误差网络
Alban Farchi和Marcin Chrust的工作是用神经网络修正IFS的系统性模式误差,过程中经历了一次失败。
离线学习:如果观测无偏,分析增量里可预测的部分可以归因于模式误差。团队用3年业务分析增量训练一个按大气柱独立处理的网络,总体能预测10%至30%的大尺度增量。把它作为强迫加进2025年的预报,Z500改进约4%,第2天达到峰值后逐渐消失,远小于离线得分暗示的幅度。原因是分析增量只是12小时窗口内累积的预报误差,与瞬时模式误差可能差别很大。
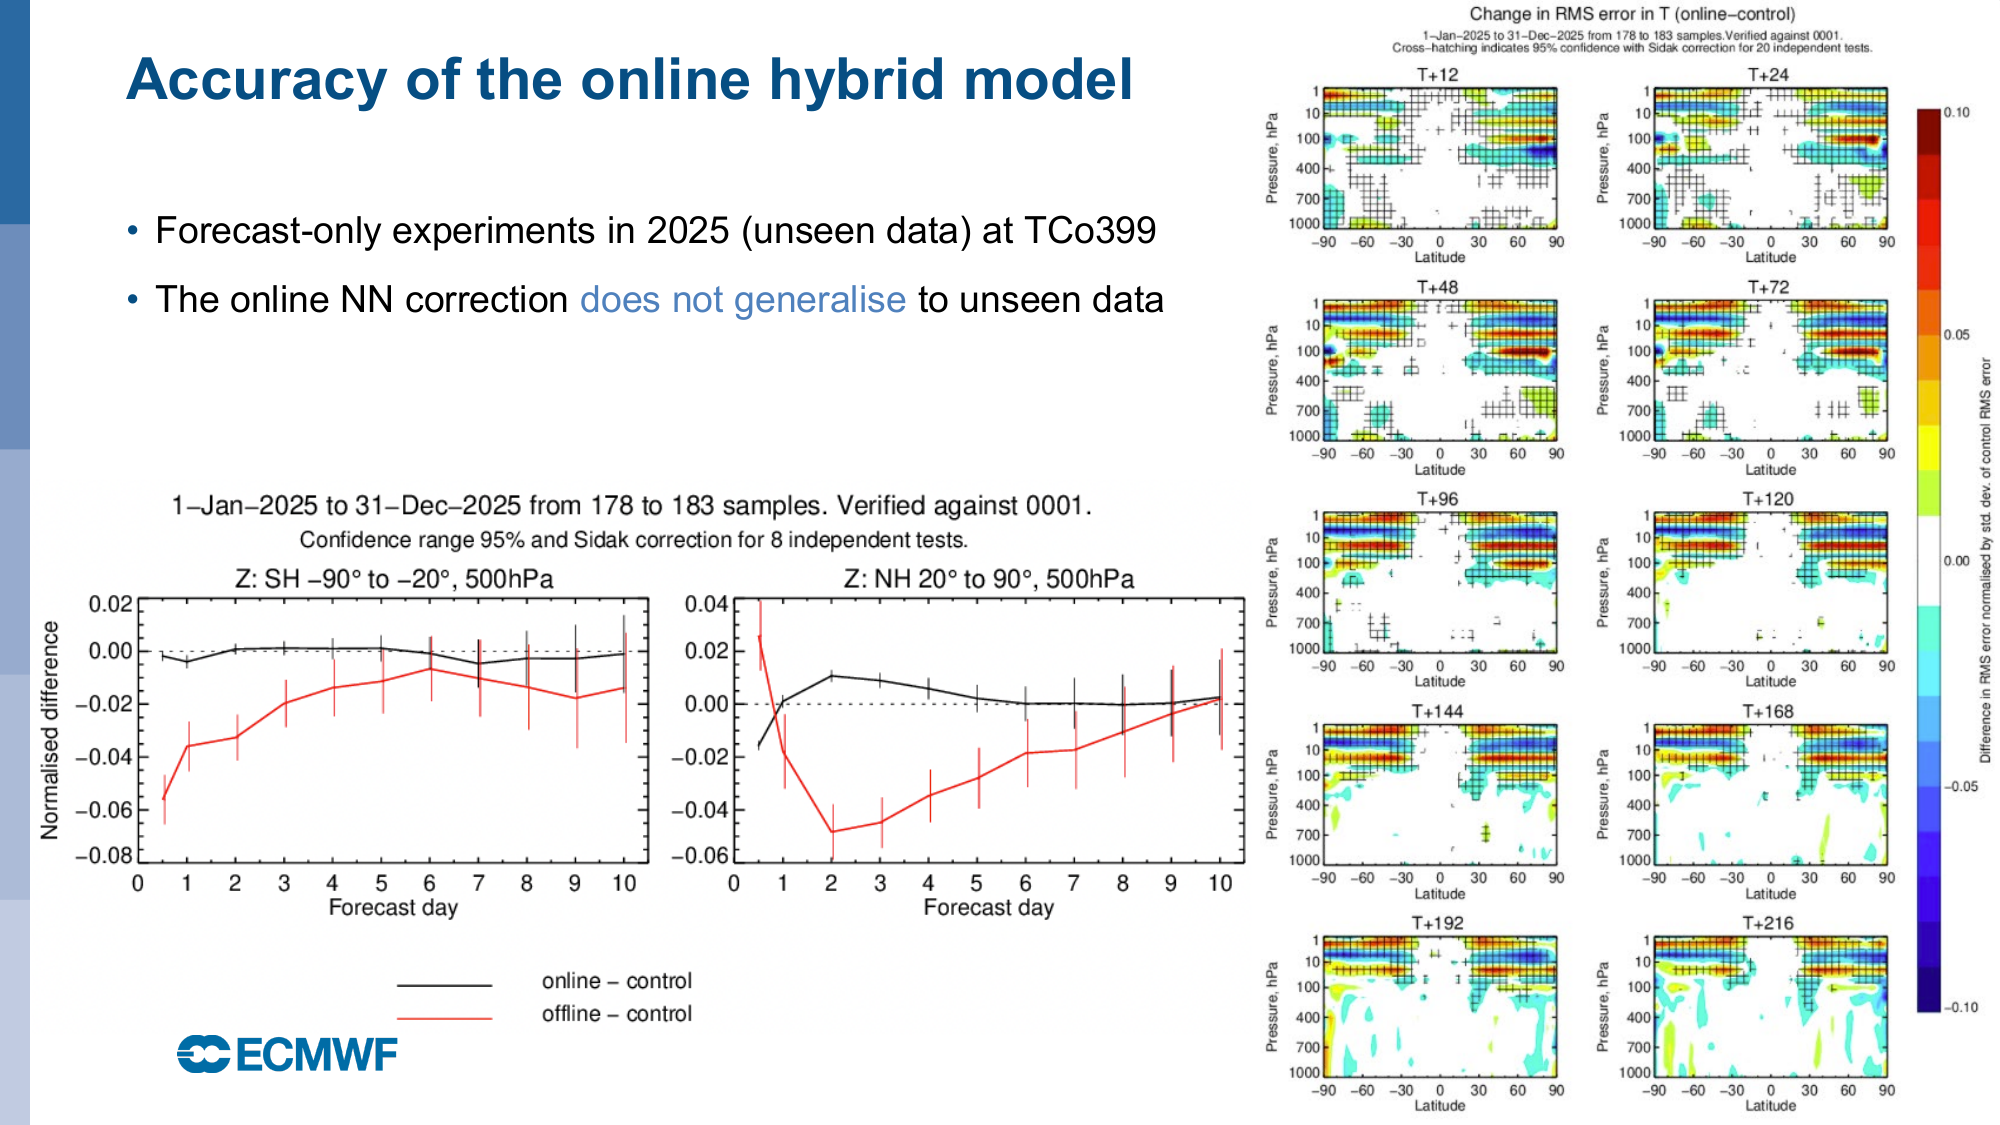
在线学习(NN 4D-Var):弱约束4D-Var允许模式在同化窗口内存在误差,并把误差项和初始状态一起估计。团队把神经网络参数放进它的控制向量,即极小化时要求解的那组变量,直接拿模式预报与观测比较来学参数。为避免观测信息在状态和参数之间分配不清,团队固定初始状态为业务分析,只估计网络参数,并把窗口从12小时延长到48小时。用2024年数据按时间顺序训练,南北半球温带位势在训练年显著改善。
换一年:同一网络拿到2025年评估,Chrust的原话是泛化“接近灾难性”,效果与不做修正持平。团队的诊断是,数值模式不是自治系统,模式误差带季节成分,按日期顺序处理会让网络只记住最近的误差、遗忘过去。
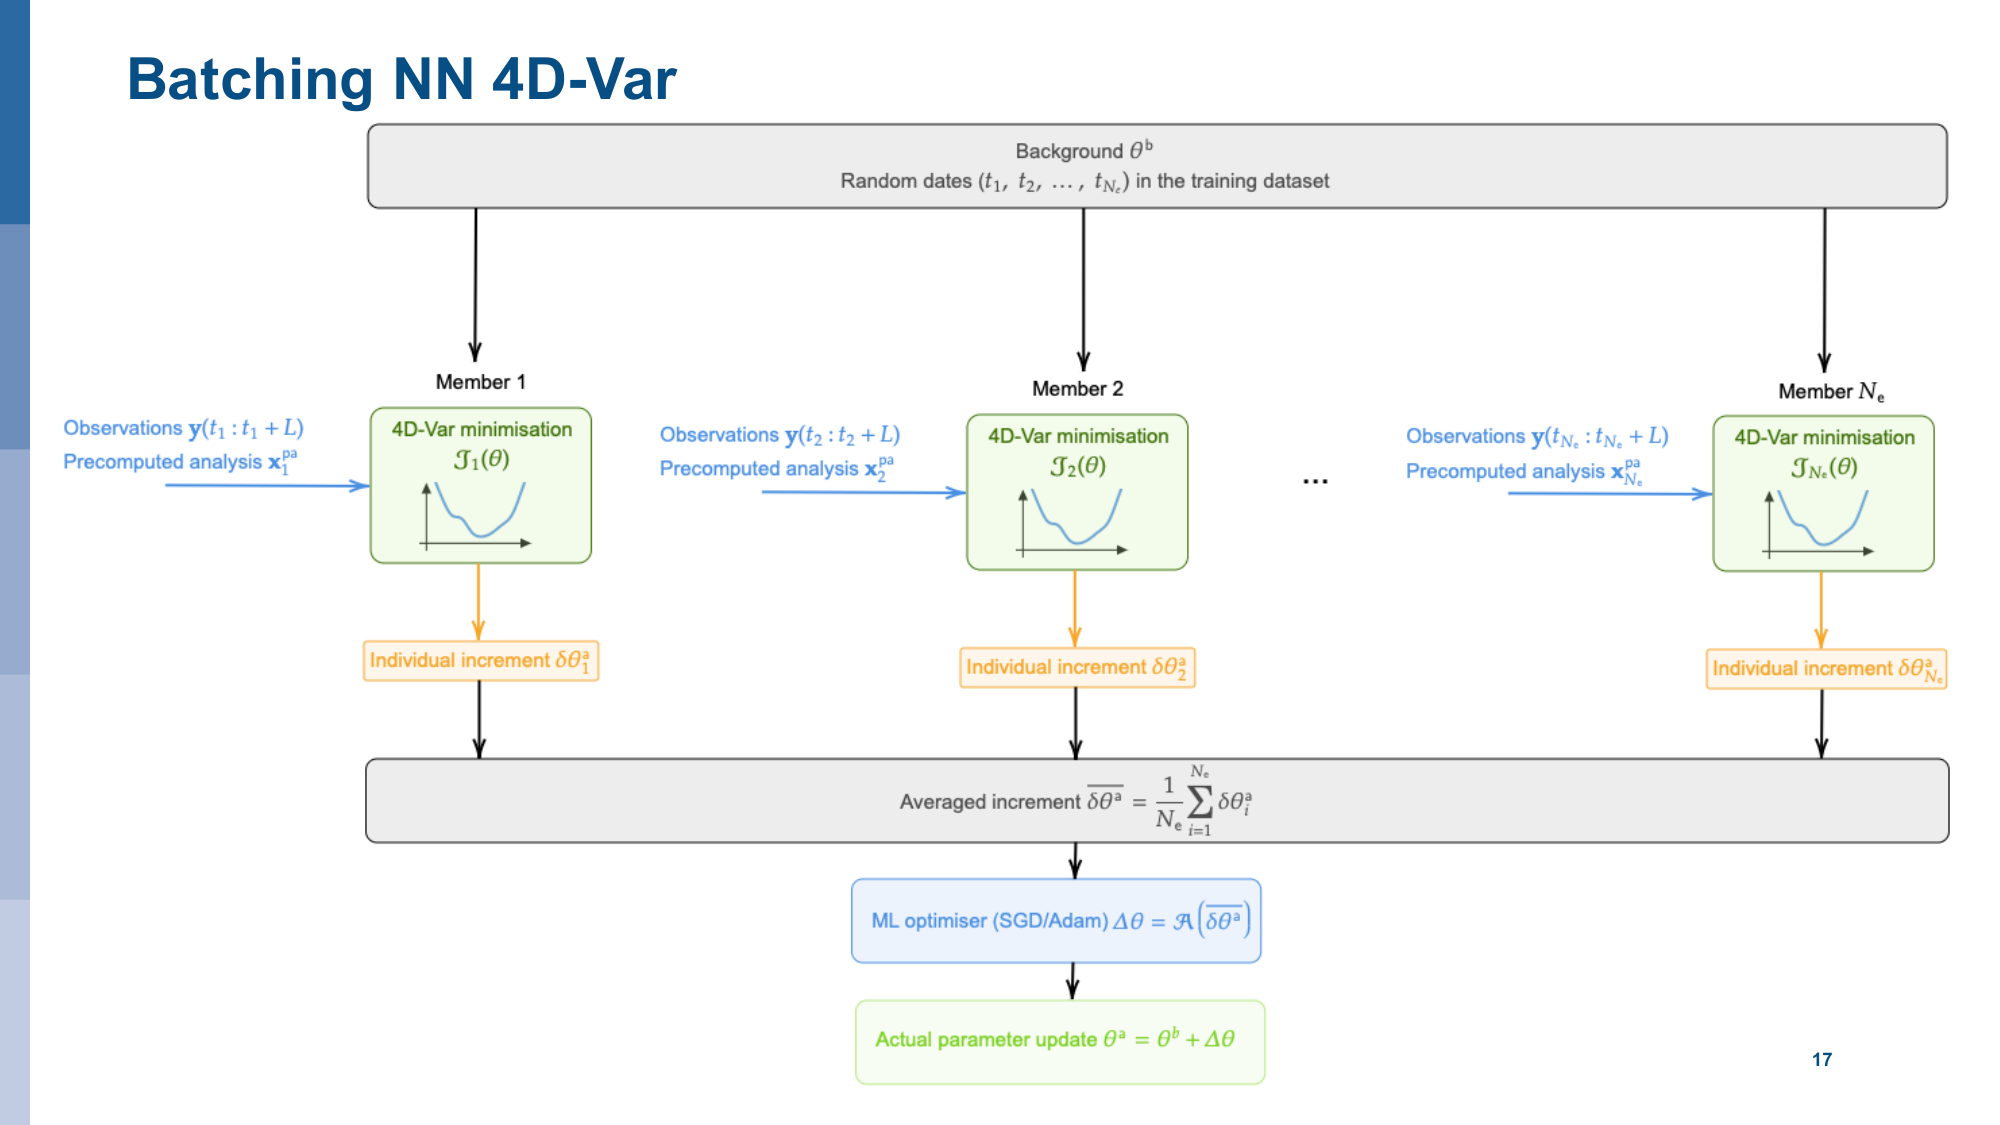
改成随机抽样:团队把一次NN 4D-Var循环类比为随机梯度下降的一次迭代,借用小批量(mini-batch)的思路,在EDA框架上同时运行多个窗口,每个成员取一个随机日期,增量平均后交给Adam优化器更新参数。
试验用8个成员,训练集为2024年的732个48小时窗口,约1个epoch。在2025年独立数据上,训练2、4、6个“虚拟月”后的网络都稳定优于离线版本,三条曲线几乎重合;大部分改进在前约100个虚拟日内就已学到。200 hPa第5天和第10天的动能谱与IFS“动力学上无法区分”,既没有注入能量也没有平滑。
这项工作仍有两处天花板:热带的改进受限于按柱处理的网络缺少水平信息,团队正通过Atlas通信库加Torch C++接口引入图神经网络;窗口超过48小时(试过3天)没有带来改进,讲者认为受限于增量4D-Var的弱非线性假设。主持人Rosemary Munro在问答环节祝贺他们“从最初的灾难中恢复”。
只有58个参数的海冰网络
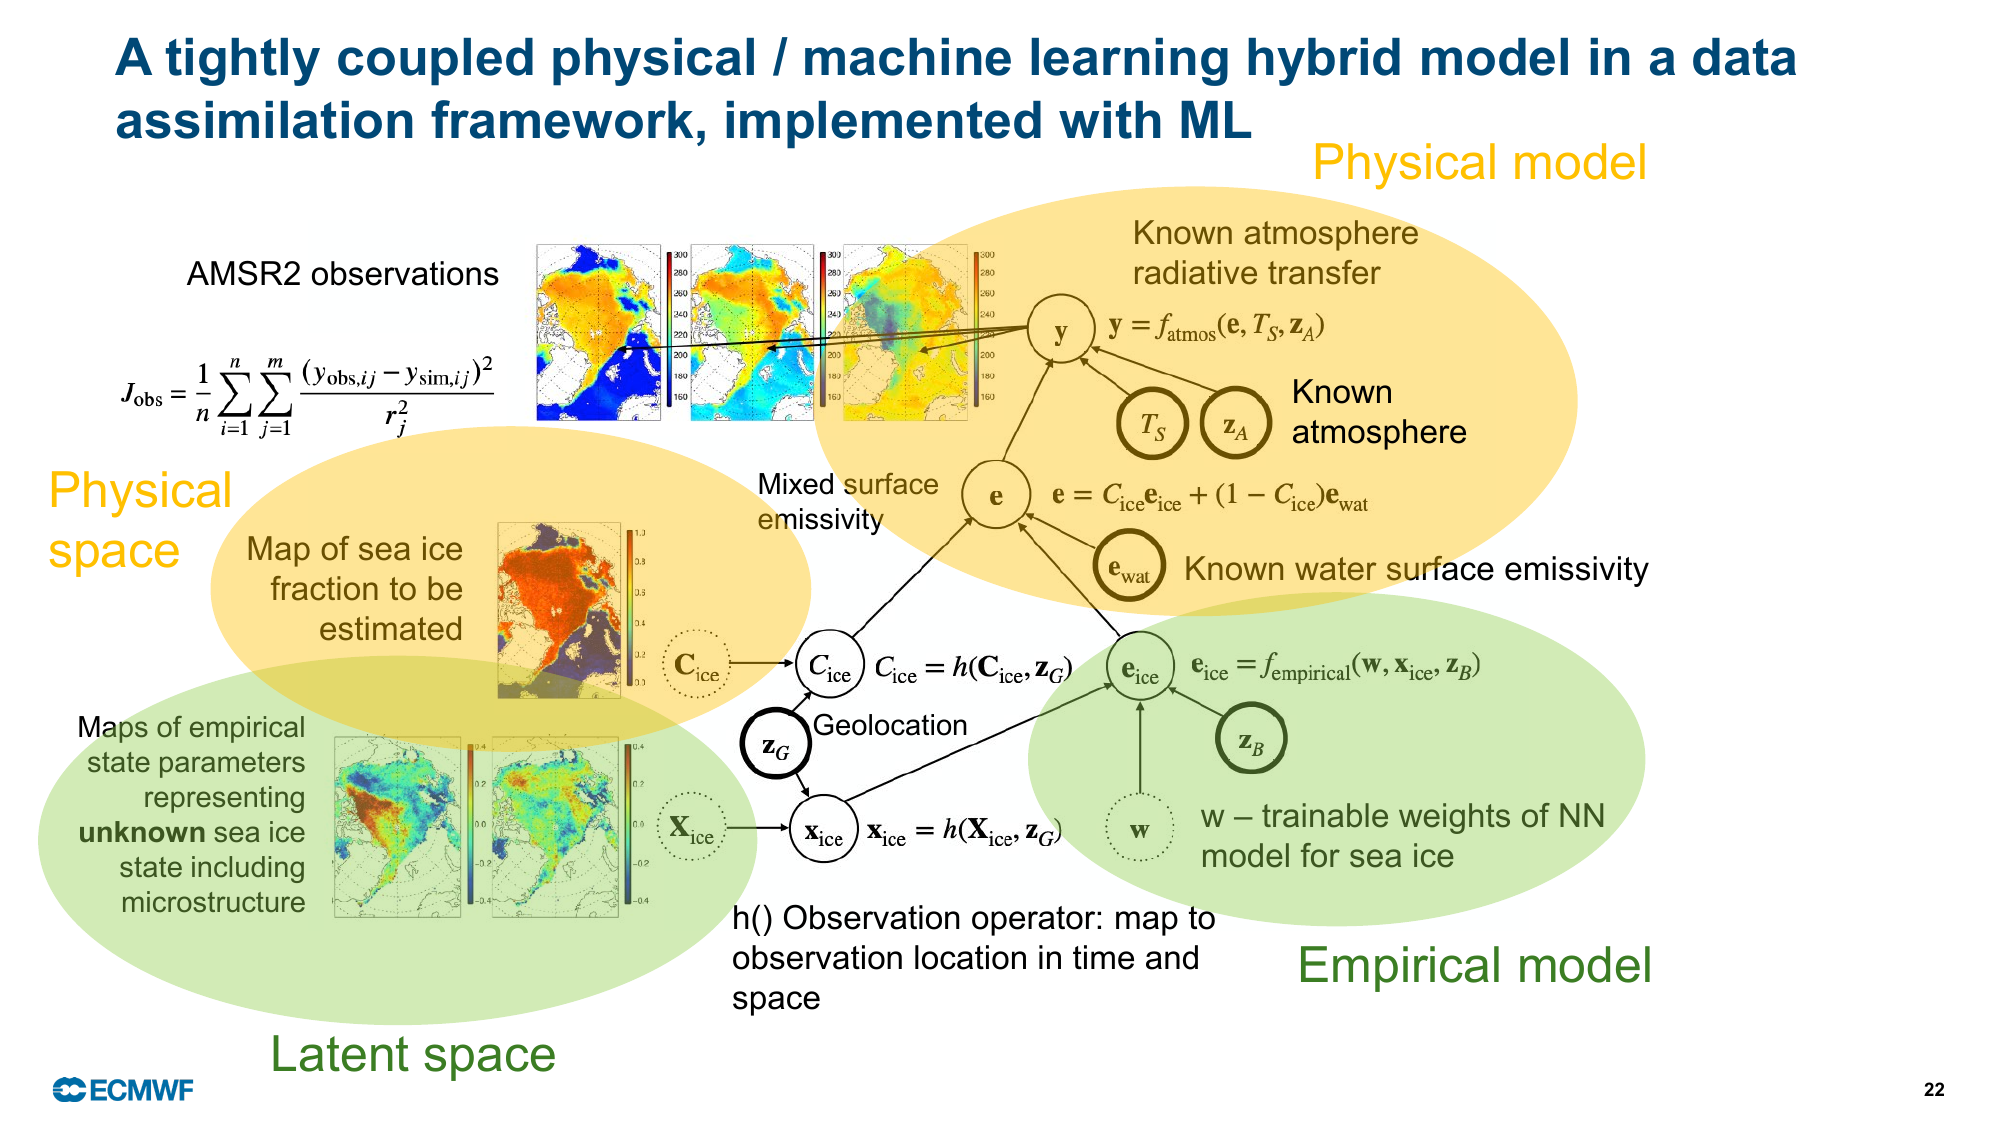
Alan Geer的报告展示了另一种结合方式:把同化目标函数和神经网络写进同一个可微框架里一起训练。
海冰微波辐射难以用物理模型算准,完整的雪冰辐射传输需要雪粒径、冰中气泡、卤水等预报模式都没有的量。历史海冰密集度产品也不可靠,ECMWF业务海洋分析OCEAN5的海冰密集度滞后48至72小时。Geer在Keras/TensorFlow中把观测代价项、先验约束和观测算子插值实现为网络层,用自动微分求梯度,对北纬45度以北的全部海洋,每天在网格上同时估计海冰密集度、3个“经验状态”隐变量,以及由这些量决定的海冰发射率。
规模对比很悬殊:一年训练数据、数百万条观测、上亿个状态变量,生成海冰发射率的神经网络只有58个可训练参数,两层,输出限定为7个平滑基函数,防止拟合出非物理的谱细节。正则化里还加了一个“凸起函数”惩罚0.1至0.3之间的低密集度值,这些值多半是被误判为海冰的云。Geer说,这种处理在随机梯度下降框架下很容易做,在高斯框架里就很难。
这套方法已在过去几个IFS版本中扩大了海冰区微波成像仪的同化覆盖;海冰密集度经耦合同化送入海洋模式NEMO后,中纬度中期预报得到改进,Geer称这可能是首次展示更好的海冰场能改进中纬度中期预报。代码已在GitHub公开。在ESA与ECMWF合作的DANTEX项目中,经验状态还被作为二维场传递到下一个同化循环的背景场,AMSR2 36 GHz的O−B随之改进。Geer的说法是,隐变量也是状态变量,可以向前传播。
NOAA:先替换零件,再碰模式
Kleist的报告是NOAA的全景,部件层面的进展最扎实:
卫星云导风超级观测:聚类算法把13.3万条大气运动矢量(AMV)合并为2.7万个超级观测,再用神经网络估计每个超级观测的误差,这项工作已因负责人离职暂停。
辐射传输模式移植:联合卫星资料同化中心(JCSDA)把通用辐射传输模式CRTM精确移植到PyTorch,与Fortran版v3.1.3的亮温和雅可比差异约10⁻¹¹ K。单块A100全天空每秒约1.3万条廓线,30核Fortran约4800条。验证雅可比时还发现了Fortran伴随代码里的两个bug。另一条路线是概率神经网络模拟器,比CRTM快约10倍、误差约0.3 K,并给出每个通道的预测误差,可用于质量控制。
海冰-海洋平衡算子:用耦合UFS背景场(1/4°的MOM6加CICE)训练海冰模拟器,以LibTorch实现,把自动微分得到的雅可比作为海冰与海洋之间的平衡关系,已作为TorchBalance算子加入JEDI。同化海冰密集度时,会沿冰缘产生符号合理的海表温度增量。
模式层面的结果偏负面。上一篇文章提到过的两项NOAA研究,GraphCast的切线性和伴随模式不能用于4D-Var,以及NeuralGCM、Pangu、GraphCast在集合卡尔曼滤波循环中发散,Kleist都放进了“没有按预期工作”的一栏。他还提到一次直接失败:用UFS重放数据在全垂直分辨率上从头训练更高维的模型,因训练数据噪声过大而“惨败”,他的结论是模型必须为同化用途专门设计。对应的投入方向是把UFS本身改写成可微模式,MPAS动力核的PyTorch移植已完成,单GPU相对单CPU约快8至10倍,物理包移植和与JEDI的连接还在进行中。
理想试验给出的几条规律
CERFACS的Selime Gürol和法国气象局的Vincent Chabot做了一个“学习资料同化”的综述,前半部分整理低维理想试验的经验,与上面几项业务尝试的遭遇对得上:
跨循环训练:只在单个分析时刻训练的方法,表现一致不如跨多个同化循环训练的方法,这与EDA模拟器只保证单循环保真、接入循环后方差失控的情况吻合。
损失函数里要有物理模式:McCabe和Brown(NeurIPS 2021)的方法在观测空间比较下一时刻预报,损失函数中包含可微模拟器;如果不经过模式、直接拿分析与观测比,网络只会学会复制观测,分析误差等于观测误差。
不假设高斯也能做好:Boudier、Gürol等提出的数据同化网络(DAN)在Lorenz-95模型上达到调优过的LETKF的水平,不需要局地化和膨胀,成员少时更好。
完全无监督仍未解决:现有文献以拿“真值”训练的概念验证为主,只从观测学习、不用物理模式的同化目前没有成功例子。
高维真实系统的结果更保守。Maddy等(2024)把AI分析作为伪观测同化进NOAA业务GDAS,比只用常规观测好,但不如用经典方法同化同样的传感器。Chabot的结论是这些方法离业务还远,各研究的观测类型、训练期长度差异太大,彼此无法比较。ECMWF的Tony McNally在问答中提议,与其每篇论文都宣称打败ECMWF,不如邀请各组每天实时运行并公开评分。
同化框架里的机器学习部件横向对比
| 部件 | 机构 | 机器学习替换了什么 | 进展 | 结果 |
|---|---|---|---|---|
| EDA方差 | ECMWF | 50成员样本方差 | 3个月循环试验,论文投稿中 | 5成员加ML与50成员基本持平 |
| EDA成员 | ECMWF | 38个成员的4D-Var | 研究版集合同化循环试验 | 单次增量合理,循环中方差持续增大 |
| 模式误差修正 | ECMWF | 系统性模式误差 | batched NN 4D-Var,2025年独立检验 | 稳定优于离线版本,热带待解决 |
| 海冰发射率与密集度 | ECMWF | 海冰地表发射率模型 | 已进入业务IFS | 扩大海冰区覆盖,耦合同化改进中纬度预报 |
| 云导风超级观测 | NOAA | 稀疏化与误差设定 | 原型,已暂停 | 13.3万条压缩为2.7万个 |
| CRTM | JCSDA/NOAA | Fortran辐射传输与手写伴随 | PyTorch移植已验证 | 差异约10⁻¹¹ K,发现2个伴随bug |
| 海冰-海洋平衡算子 | NOAA | 耦合背景误差中的平衡关系 | 已加入JEDI | 冰缘SST增量符号合理 |
| AI模式替换物理模式 | NOAA | 循环中的预报模式 | 研究 | 未观测变量不物理,部分滤波发散 |
走通的做法有什么共同点
把表里的结果放在一起看,走通的几项都把同化框架原有的约束留在了原处。方差模拟器只替换B矩阵中的方差,平衡关系和相关结构仍由原系统提供,4D-Var增量对B的连续性给误差设了上限。batched NN 4D-Var的参数更新来自增量4D-Var,损失直接以观测为准,学到的修正受到动力学检验。Geer的海冰网络嵌在观测代价函数里,参数少到无法拟合出非物理细节,先验约束直接写进目标函数。CRTM的PyTorch版本精确复刻物理,反过来还成了检查原有伴随代码的工具。
出问题的几项,恰好拿掉了某种约束:模拟成员绕过了“离散度、B矩阵、观测权重”之间的负反馈;按时间顺序训练的网络失去了对不同季节样本的覆盖;AI预报模式放进循环后,跨变量的背景协方差和切线性行为都不再受物理控制。Gürol综述里“损失函数里要有物理模式,否则只会复制观测”的结论,是同一件事在理想试验里的版本。
研讨会第一场讨论中现场举手时,认为“不加机器学习的经典同化在业务上还有未来”的人很少,再分析是例外。
接下来的节点
ECMWF方面,EDA成员模拟器的新版本已在开发,目标是先解决循环稳定性,长期计划是在流匹配模型中加入随机项,廉价地扩充集合;讲者预计将来IFS升级时只需微调模拟器,不必重新设计方法。模式误差网络的下一步是改在格点空间加强迫、用u/v和比湿替代涡度散度、通过Torch C++接入图神经网络,最终在循环4D-Var中使用混合模式,使分析和预报对模式误差的处理一致。陆面方面,2026年9月启动的CHERRI项目计划用机器学习模拟器获取陆面模式的切线性和伴随。
NOAA方面,可微MPAS的物理包移植和与JEDI的连接是近期重点;Kleist在问答中说,传统模式和经典同化不会很快消失,但它们留在实时关键路径上的日子“屈指可数”。他最看好的是用混合方法解决背景误差和耦合同化这类老问题。